主题
RWork
本地优先的 AI 工作台:多模型对话、工具调用与本机用量审计账本
项目是做什么的
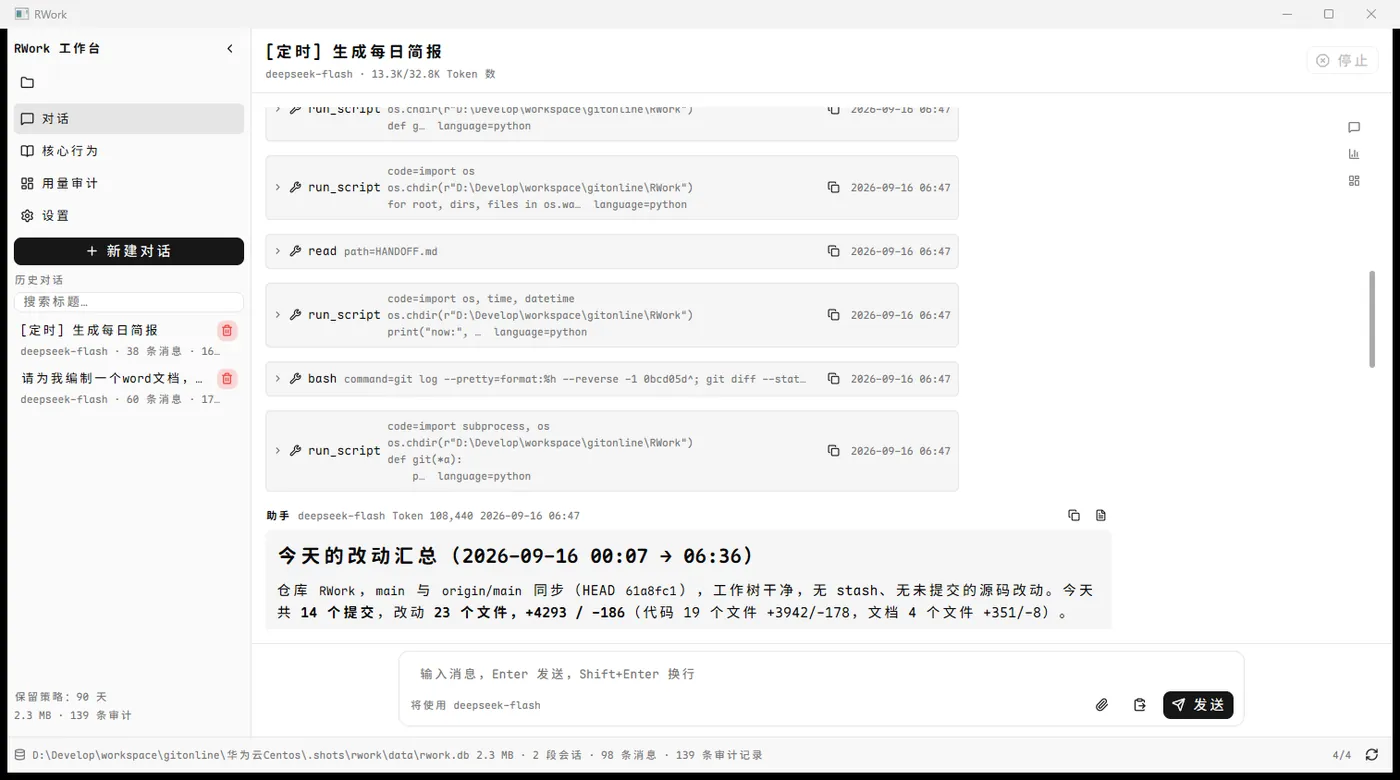
RWork 是一个本地优先的 AI 工作台,面向需要在桌面端同时使用多家大模型、并且要清楚知道「这次对话烧了多少钱」的人。
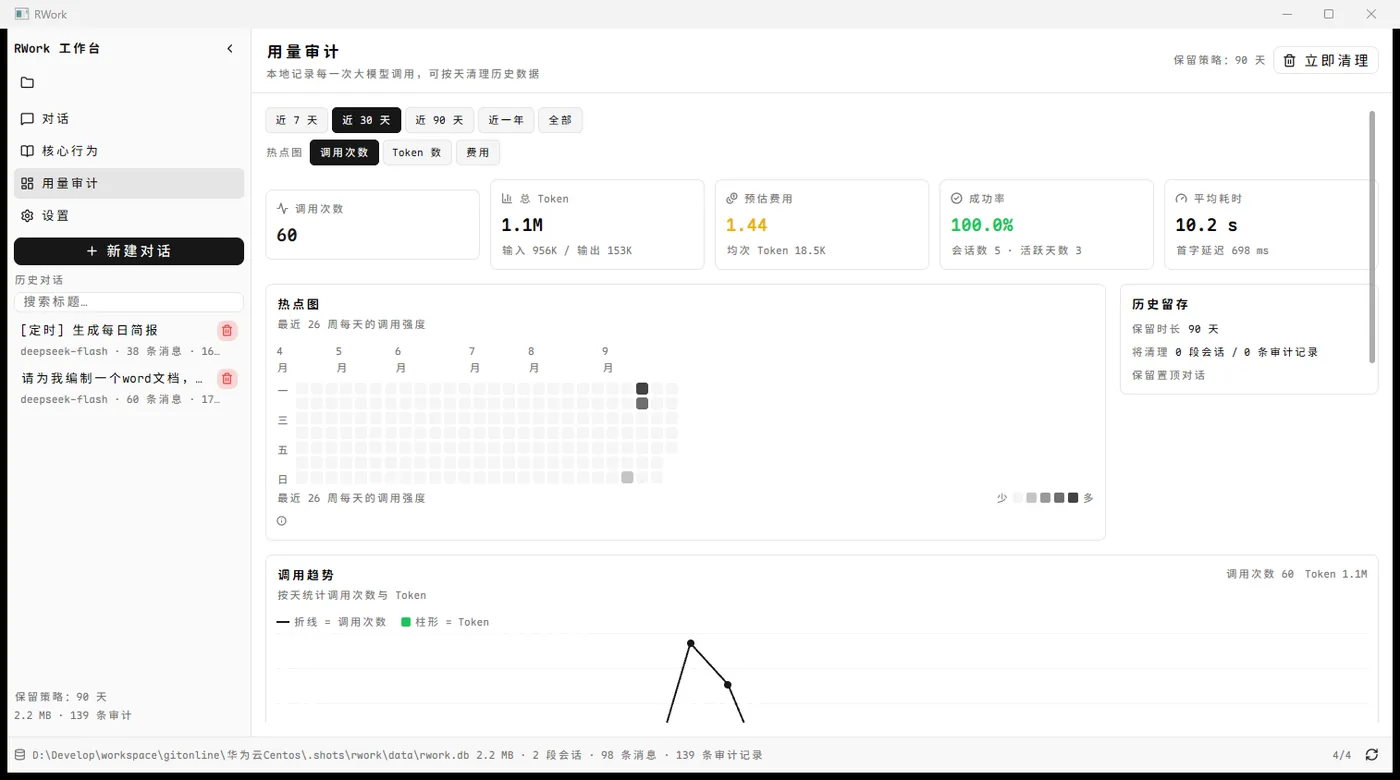
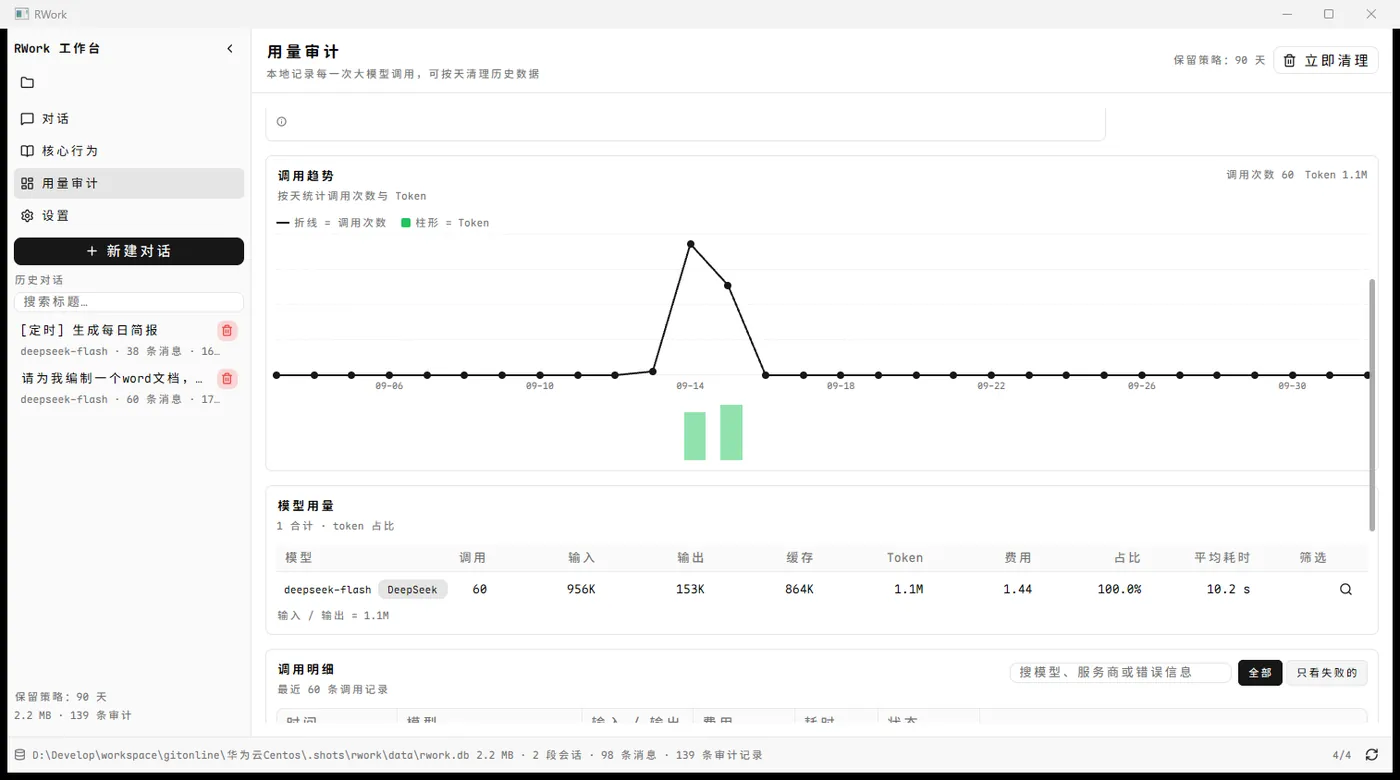
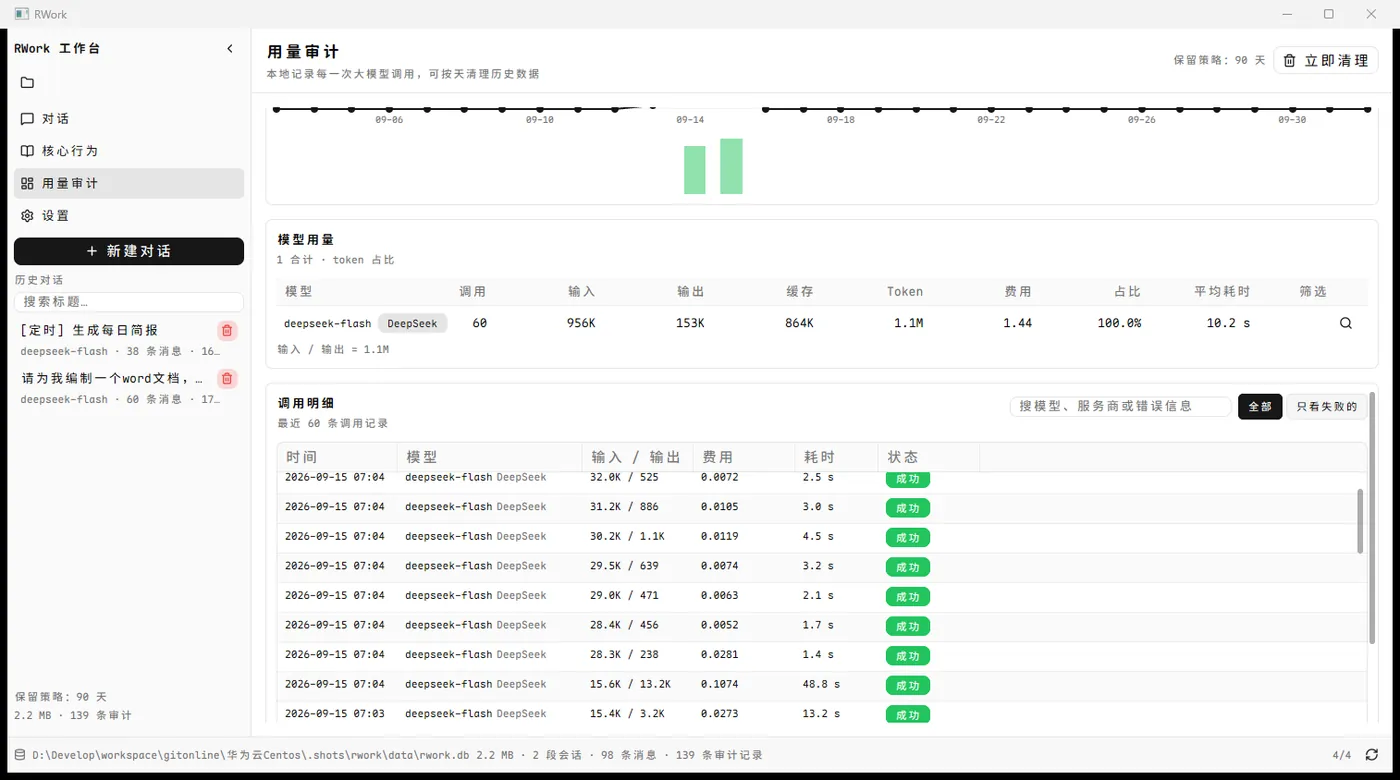
它把对话、工具调用、权限管控、长期记忆和成本审计放进同一个程序:工具调用覆盖 OpenAI、Anthropic、Ollama 三种协议方言,可按内容研判与历史授权决定是否放行;记忆分会话 / 项目 / 全局三档,召回分档与取用记录都查得到;用量账本用内嵌 SQLite 记录 token、费用、耗时与首字延迟,并给出日历热点图与历史留存策略。
因为是本地优先,模型凭据、对话记录、审计数据都只落在本机,适合对数据流向敏感的开发场景。
核心能力
- 流式对话与推理通道展示,带上下文预算的结构化压缩
- 实验运行器(0.4.0,只做预览规划):设置页「实验」分页的开关都有真实消费者,生成计划会写出 namespace、阶段表与 4k/3k 预算账本,不发模型请求
- 提示词纪律与 harness 检查(0.3.0):系统提示可追加「无评分标准 / 证据是数据 / always-on 成本 / 交付物形状」四块纪律;设置里只读列出 skill 的触发与目录合法性
- 落盘件索引(0.3.0):
context/与pastes/文件可查路径、种类、字符数、sha256 与会话归属 - 跨 OpenAI / Anthropic / Ollama 三种方言的工具调用:读写文件、搜索、执行命令、MCP
- 分层权限引擎:read / write / exec + 内容研判 + 历史授权学习
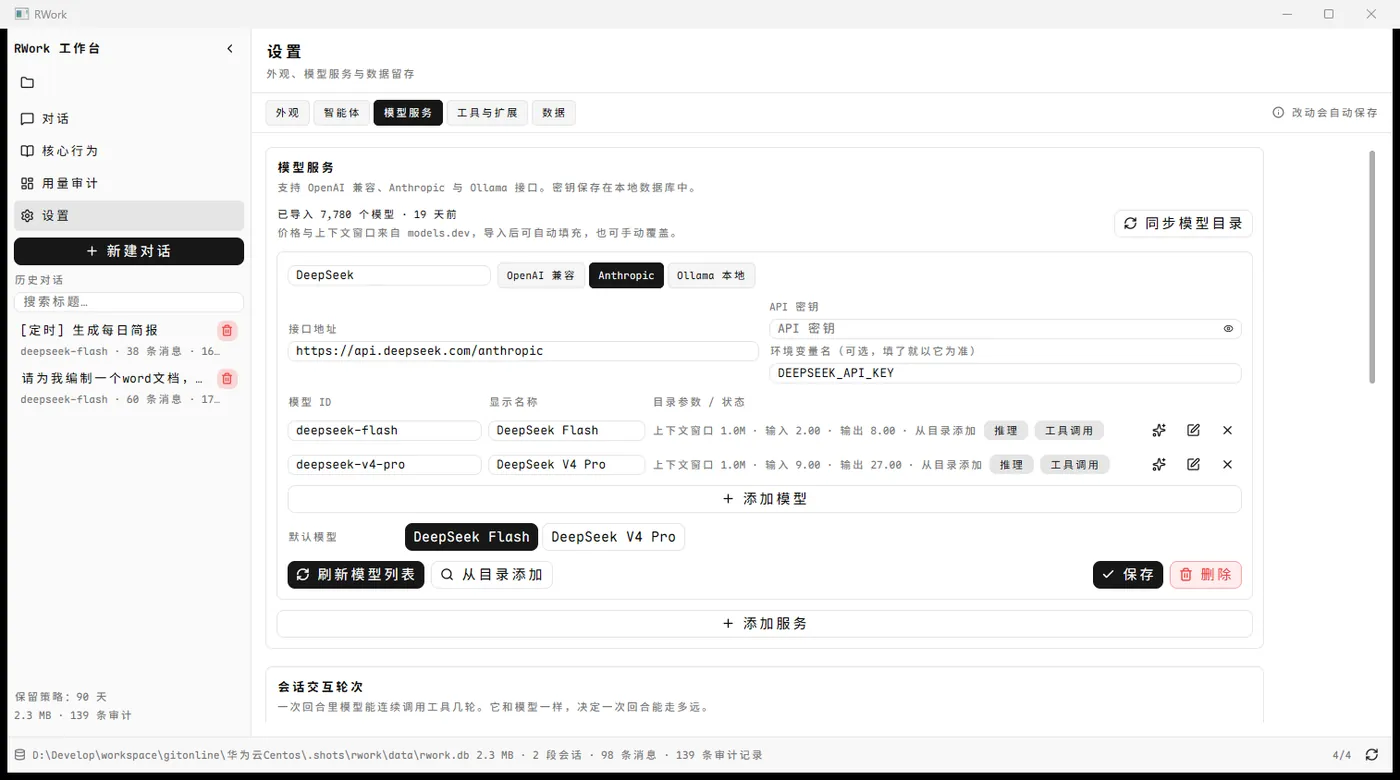
- 内置 models.dev 模型目录(价格与上下文窗口)
- 本地 SQLite 用量审计:token、费用、耗时、首字延迟、日历热点图
- 长期记忆与任务(核心行为页):分会话 / 项目 / 全局三档,关键词触发 + 向量召回按相似度分档注入;「决定与待办」不看相似度,按类别每轮单独成节
- 执行计划:像多件事的输入先拆成带完成条件的步骤(依赖构成 DAG)按图执行,每步按条件审计,上游失效就退回最早那一步、受影响的步骤一起重做
- 无人值守:关窗口只是收进托盘、进程继续跑(定时任务照常执行),托盘常驻 + 开机自启,被中断的那一轮任务下次启动接着做
- 全部数据留在本机,不上传任何用量与对话内容
界面截图
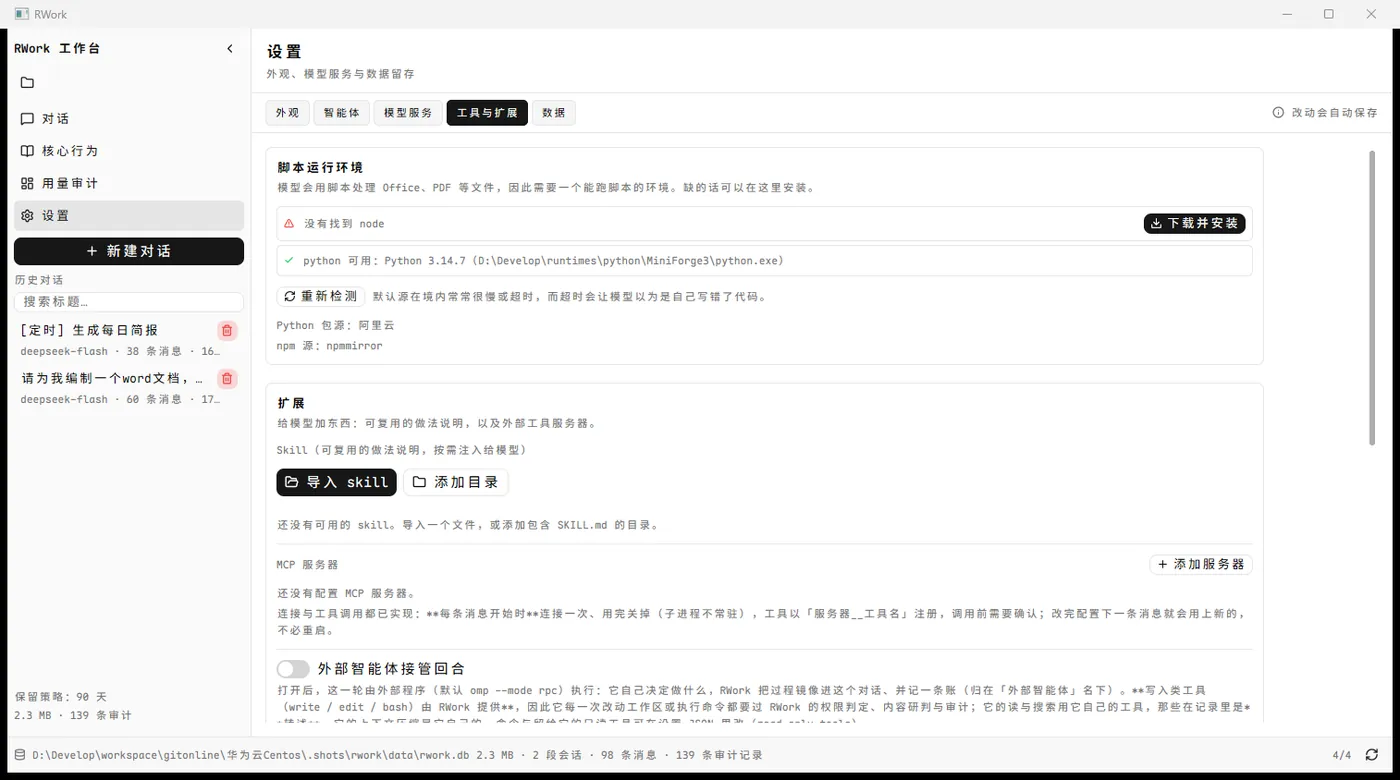
点击任意截图可放大查看;截图都是本机真实运行程序后截的。
获取方式
暂未提供公开二进制,构建步骤见仓库 README;也可以直接邮件问我。
发版记录
- v0.4.0(2026-10-21)—— 详见发版信息。